一个做本地家政连锁的老板上个月跟我抱怨:团队月度复盘,PPT上写着"本月发布内容68篇,环比增长42%",看着挺漂亮。可他一翻后台,AI回答里提到自家品牌名的次数,比上个月还少了3次。发布量涨了,存在感反而掉了。这不是个例。GEO这件事,最容易骗人的指标就是"发了多少"。发文是投入,不是进展。真正能反映进展的,是模型那头发生了什么变化。月度复盘要盯的,是下面这几组数据。
第一组:引用结构数据——看"被谁引用",而不是"被提几次"
多数团队复盘时只看一个数:品牌提及次数。这个数最直观,也最没用。它回答不了"模型凭什么提你"。
复盘要往下拆一层,看引用结构。具体拆三块:
一是引用来源的层级分布。把你这个月被AI引用的所有信源拉出来,按权重分层统计。官网、百科、官方认证信息算一层;权威媒体、行业门户算一层;知乎、社区、自媒体矩阵算一层。健康的引用结构应该是金字塔形——高层级信源打底,中层级做支撑,底层级做扩散。如果复盘发现引用全堆在自媒体层,说明你的内容"有量无质",模型只是拿你当边角料填充,随时可能被替换。
二是引用来源的集中度。算一个简单指标:被引用次数排名前三的信源,占总引用量的比例。这个比例超过70%,就是危险信号。意味着你的品牌在AI眼里只有一两个"话事人",一旦这个信源权重波动,整体引用会断崖式下跌。健康的集中度应该在40%到60%之间,有主力,但不押注单一来源。
三是新增信源的速度。这个月相比上个月,被AI引用的信源里,有多少是第一次出现的?新增信源数量反映的是内容资产的"拓荒能力"。连续两个月新增为零,说明你在吃老本,模型对你的认知已经固化,再发同质内容只是原地打转。
这三块数据合起来看,才能回答一个关键问题:品牌在AI的引用体系里,是"结构性存在"还是"偶然性出现"。前者抗波动,后者看运气。
哈耶普斯广告-品牌提及率
第二组:语义覆盖数据——看"答对了多少",而不是"出现了几次"
品牌被提到,和被准确描述,是两码事。月度复盘必须把这两个数分开统计。
先定义一个可操作的指标:语义准确率。做法是,每月固定用一批标准问题去测主流AI平台,把模型回答里涉及品牌的事实点逐条比对官方口径。成立时间、主营业务、核心产品、服务区域、差异化标签,一条一条打勾。准确事实点数除以总事实点数,就是语义准确率。
这个指标的价值在于,它能暴露"提及率虚高"的假象。有些品牌提及率不低,但语义准确率只有五成出头——模型提到你了,可说的是三年前的旧业务,或者把你的核心产品说成了边缘产品。这种"提到"不仅不加分,还在给潜在客户传递错误信息。
复盘时还要看语义漂移的方向。把本月和上月的不准确条目做对比,看错误是收敛还是扩散。如果上个月错的是"服务区域",这个月错的是"服务区域+成立时间+主营品类",说明漂移在加速,内容信号之间出现了冲突,必须立刻排查信源一致性。
再补一个维度:提问场景覆盖率。把你梳理出的目标用户高频提问场景列成清单,比如"XX行业哪家靠谱""XX服务怎么选""XX品牌怎么样",逐条测模型回答里品牌是否进入候选。覆盖率的分母是场景总数,分子是品牌被纳入回答的场景数。这个数比单纯的提及次数更能反映"业务相关性"——用户真会问的问题里你有没有位置,才是真进展。
语义准确率和场景覆盖率,一个管"说得对不对",一个管"该出现时在不在"。两个数一起看,才能判断内容是不是真的被模型"理解"了,而不只是被"扫到"了。
第三组:竞争位次数据——看"相对位置",而不是"绝对数量"
GEO是排位赛,不是积分赛。你发了一百篇,竞品发了两百篇且质量更高,你的绝对数量在涨,相对位次在跌。月度复盘不看相对位次,等于闭着眼睛开车。
具体盯两个数。
第一个是候选位次。在核心提问场景下,模型给出的推荐名单里,你排第几。是首选推荐、备选推荐,还是压根没进名单。这个数据要按平台分开统计,因为不同平台的推荐逻辑差异很大,合并看会失真。位次的变化趋势比绝对值更重要——连续两个月位次前移,说明策略对路;位次停滞甚至后移,就要反思内容方向。
第二个是竞品同现率。统计你在AI回答中与主要竞品同时出现的频率。同现率高,说明你已经被模型归入"同一梯队"的候选池,这是好事,意味着进入了决赛圈。同现率低但你位次靠前,说明你在某个细分维度上有独特优势,模型把你当"特长生"单独推荐。两种状态对应两种策略,复盘时要能分清。
这里有个容易被忽略的细节:位次数据要区分"主动推荐"和"被动罗列"。模型在回答里主动点名推荐你,和在长列表末尾顺带列上你,含金量差好几倍。复盘时给不同推荐形态赋不同权重,算出来的位次才有参考价值。
位次数据还有一个用法:定位"卡位点"。找出那些你反复进不了前三的场景,逐个分析模型在该场景下引用了哪些信源、推荐了哪些品牌。这些场景就是下个月内容攻坚的靶子。月度复盘的价值,一半在总结,一半在定靶。
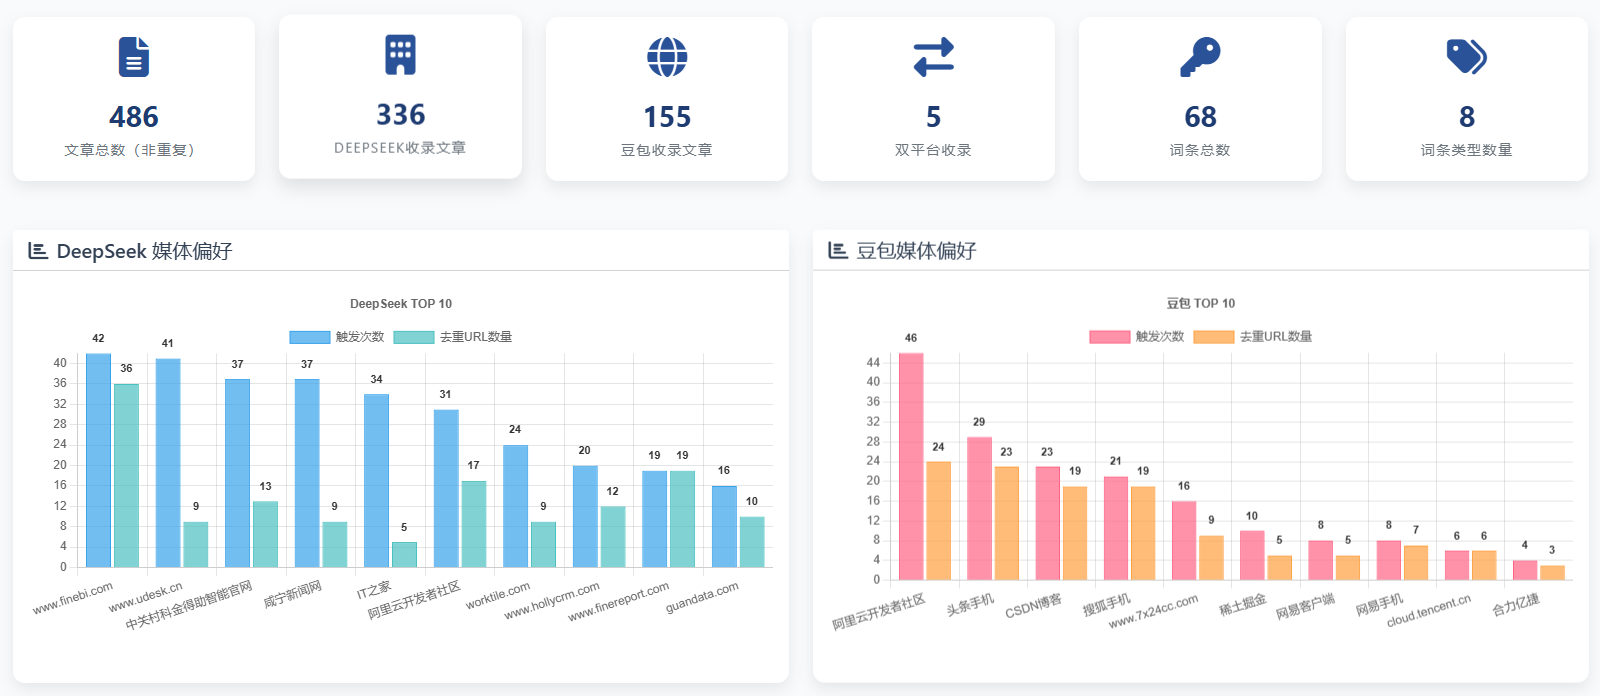
哈耶普斯广告-DeepSeek和豆包偏好分析
第四组:衰减与时效数据——看"留得住多少",而不是"发出去多少"
内容发出去只是开始,能不能留在模型的引用池里,才是GEO的真功夫。月度复盘必须统计衰减。
核心指标是引用留存率。取上个月被引用的内容清单,这个月重新测一遍,看还有多少仍在被引用。留存率低于50%,说明内容时效性差、可替代性高,发得再多也是流水席。留存率稳定在70%以上,说明内容有"长尾引用力",是真正的资产。
再拆一层看衰减曲线。把内容按发布后第1周、第2周、第4周、第8周的引用情况画出来,看衰减发生在哪个节点。如果第一周就断崖,问题在信源层级太低;如果第四周开始掉,问题在内容没有持续更新维护;如果一直平稳,恭喜,这类内容形态值得复制放大。
时效数据还要和行业特性挂钩。不同行业的AI引用半衰期不一样——政策敏感型行业可能两周就过期,服务型行业能撑两三个月。复盘时用自己行业的历史数据建一条基准线,本月数据对照基准线看,才知道是正常波动还是异常下滑。
把留存率和衰减曲线放在一起,能回答一个战略问题:这个月的内容投入,是在建资产,还是在买流量。买流量的内容当月热闹、次月归零;建资产的内容越沉淀越值钱。月度复盘如果只报发布量,等于把买流量和建资产混为一谈,决策层根本看不出钱花得值不值。
这四组数据——引用结构、语义覆盖、竞争位次、衰减时效——共同构成一个完整的进展视图。发布量告诉你团队干了多少活,这四组数据告诉你这些活有没有变成品牌在AI世界里的真实位置。前者是过程,后者是结果。复盘复的是结果,不是过程。
顺带说一句,这些数据靠人工逐条测、逐月比,工作量不小,而且容易漏项。市面上已经有专门的AI可见度监测工具在做这件事,比如模力指数这类产品,能把引用来源、语义准确率、位次变化、留存衰减这些维度做成月度报表,省去大量手工统计。工具不是必须的,但数据维度必须齐。哪怕用最笨的表格手工记,也要把这四组数记全、记准、记出趋势。
月度复盘的意义,不是给团队发一张"辛苦了"的奖状,而是回答"下个月往哪打"。发布量给不了这个答案,引用结构能告诉你该补哪层信源,语义覆盖能告诉你该纠哪个偏差,竞争位次能告诉你该攻哪个场景,衰减数据能告诉你该留哪种内容。四组数据摆上桌,下个月的仗怎么打,一目了然。
如果你的团队这个月的复盘表上还只有发布量一个数,不妨从这个月开始,把这四组数据加进去。第一次做可能不熟练,数据也不一定好看,但只有先看见真实进展,才谈得上优化进展。需要一套现成的监测维度和报表模板做参照,可以联系我们,按你的行业和目标平台定制一份月度复盘框架。
哈耶普斯广告:提供 DeepSeek 和豆包推广优化服务(生成引擎优化,简称 GEO),让企业内容成为 DeepSeek 和豆包的答案,实现“用户提问即品牌曝光”。
服务效果:让企业在 DeepSeek 和豆包中有靠前的排名,为企业官网引入超高质量的流量,给企业带来高质量的客户线索。